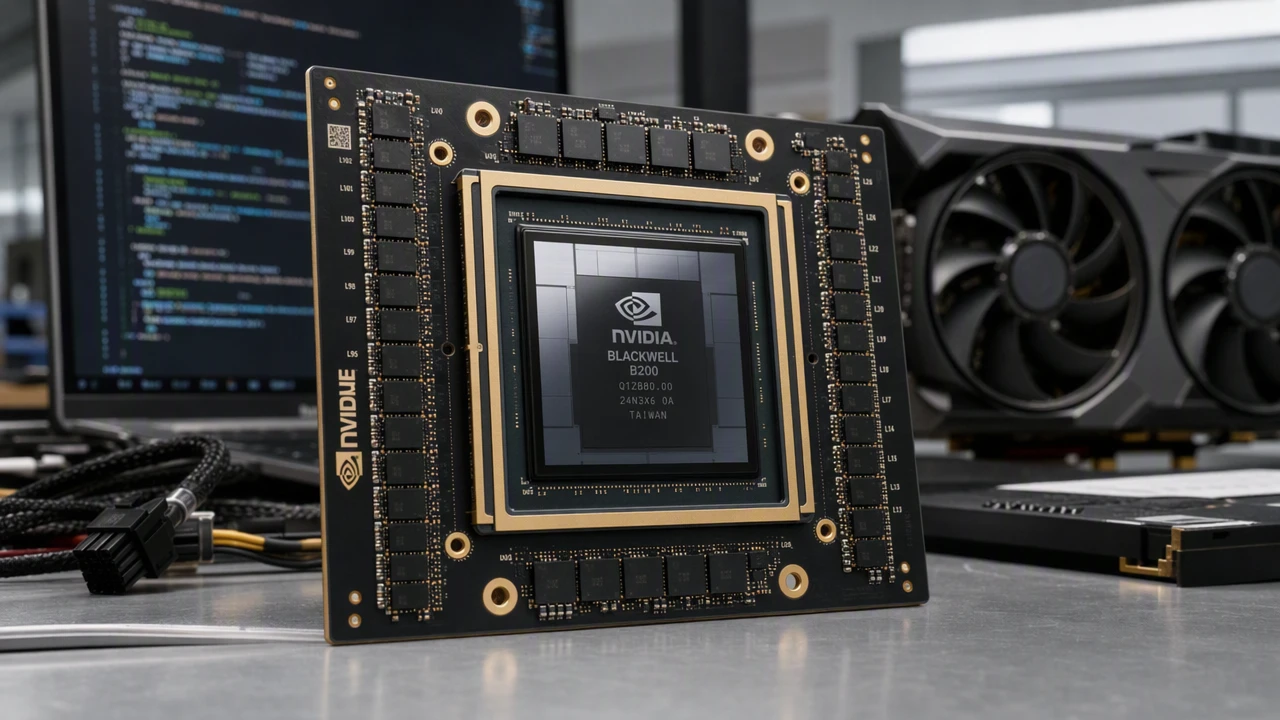
在今年的 GTC 大会上,NVIDIA 把全新 Blackwell 架构的 B200 芯片亮相。和上一代的 Ada Lovelace 系列相比,B200 最大的卖点是对最新的 FP8 计算单元的深度优化,以及针对 Transformer 工作负载专门设计的加速引擎。简而言之,B200 把“算力”这件事做得更省钱、更快,尤其在大模型的训练和推理阶段能真正把成本压下来。
技术亮点概览
B200 采用了全新的 Blackwell 架构,核心改进体现在三方面。第一是 FP8 计算单元的密度提升,能够在保持精度的前提下,用更少的算力完成同样的矩阵乘法。第二是专用的 Transformer Engine,它把注意力机制的关键步骤(如 QKV 计算、Softmax)搬到了硬件层面,实现了更低的延迟和更高的吞吐。第三是片上高速缓存结构的重新组织,提升了数据搬运效率,尤其在处理大规模模型的梯度累加时表现更稳。
对 AI 训练与推理成本的影响
从实际使用角度看,B200 对训练成本的直接好处体现在两点:一是同等算力下可以使用更低精度的 FP8,从而减少显存占用和功耗;二是 Transformer Engine 的加速让每一步训练迭代时间缩短,整体训练周期相应下降。对于推理而言,B200 的低延迟特性让实时服务的响应时间更具竞争力,尤其在大模型在线推理场景下,能够在不牺牲精度的前提下显著降低每次请求的能耗。
生态适配与实际采用
技术再好,离不开软件生态的支撑。NVIDIA 已经在 CUDA、cuDNN 以及最新的 TensorRT 中加入对 FP8 和 Blackwell 特有指令的原生支持,主流的深度学习框架(如 PyTorch、TensorFlow)也在相继发布对应的适配插件。云平台方面,几大主流云服务商已经在内部测试 B200,计划在下季度的实例中提供加速选项,这意味着开发者可以在不更换代码的情况下直接受益于新芯片的性能提升。
从项目决策的角度来看,如果你的工作负载主要是大模型的训练或高并发的推理服务,且已经在使用 NVIDIA 生态的工具链,那么 B200 值得在下一轮硬件升级时列入考虑。相反,如果你的模型规模较小,或者对低精度计算的支持尚未成熟,短期内切换的收益可能不如预期。总的来说,B200 把“更高算力+更低成本”这两个目标结合得更紧密,是当前 AI 基础设施升级的一个值得关注的节点。